
Com o DVC, versionar grandes volumes de dados nunca foi tão simples!
Vimos no mês passado a importância de se versionar código e exploramos o GitLab, uma plataforma para desenvolvimento e colaboração (ver post), e seus principais comandos (ver post).
Porém, se você trabalha com dados ou inteligência artificial, provavelmente já se deparou com desafios relacionados ao versionamento de dados e modelos de IA.
Muitas vezes, o processo de gerenciar mudanças em grandes volumes de dados ou manter a integridade dos modelos é complicado, mas o DVC (Data Version Control) surge como uma solução poderosa para esses problemas.
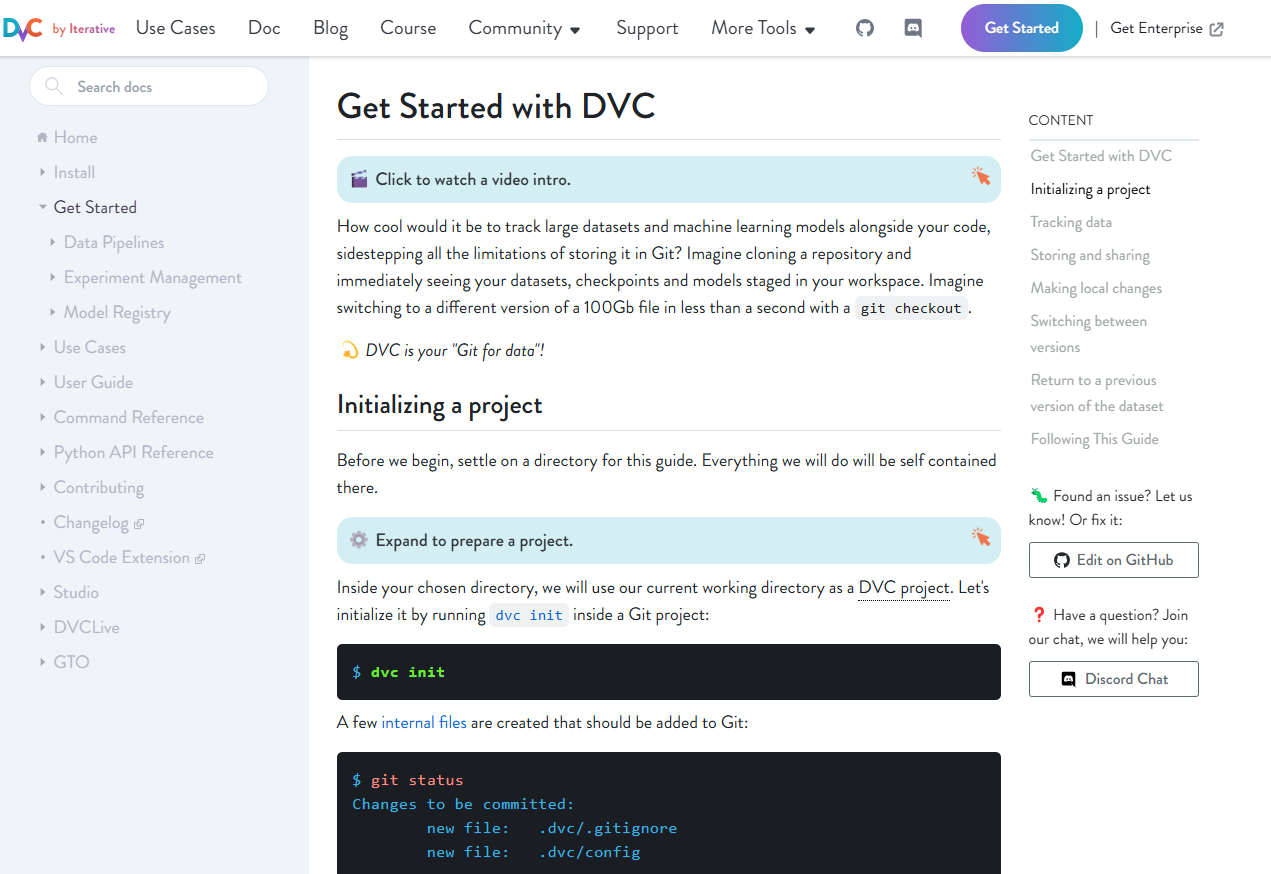
DVC é uma ferramenta de código aberto (Github) que oferece uma maneira eficiente e simples de versionar dados e modelos, além de automatizar o processo de pipeline de dados.
Essa ferramenta é especialmente útil em ambientes colaborativos, pois permite que você compartilhe e controle versões de dados de maneira eficaz, assim como o Git faz com o código.
Por Que Usar o DVC?
Embora Git seja uma ferramenta fantástica para versionar código, ela não é ideal para grandes volumes de dados, como conjuntos de dados de treinamento ou modelos de machine learning, por várias razões:
- Limitações de Armazenamento: Git não lida bem com arquivos grandes e binários, pois os mantém no repositório, o que aumenta o tamanho do repositório e dificulta a gestão de versões.
- Desempenho: A cada modificação em um grande arquivo de dados, o Git armazena uma nova cópia do arquivo completo, o que pode tornar o processo muito lento e ineficiente.
O DVC fornece uma solução especializada para versionamento desses dados, permitindo que você versionifique grandes arquivos de dados e modelos sem sobrecarregar o repositório Git.
Principais Benefícios do DVC
- Versionamento de Dados com Facilidade: Semelhante ao Git, o DVC permite que você versionifique grandes conjuntos de dados, mantendo o controle sobre alterações sem perder o histórico. Isso ajuda a evitar erros e facilita o trabalho em equipe.
- Reprodutibilidade de Experimentos: O DVC facilita a reprodutibilidade de experimentos, uma prática fundamental na ciência de dados e no desenvolvimento de IA. Com ele, você pode facilmente compartilhar o estado de seu projeto, garantir que os outros repliquem os mesmos resultados e acompanhar as mudanças ao longo do tempo.
- Integração com Git: O DVC integra-se ao Git, o que significa que você pode continuar usando as ferramentas que já conhece enquanto gerencia dados e modelos. Ele funciona de forma simples e intuitiva, sem a necessidade de aprender algo completamente novo.
- Automatização e Pipelines de Dados: O DVC não só ajuda no versionamento de dados, mas também oferece uma maneira de criar pipelines de dados que automatizam tarefas repetitivas e otimizam fluxos de trabalho.
- Trabalho Colaborativo: O DVC facilita o trabalho em equipe, permitindo que várias pessoas colaborem em um mesmo projeto sem problemas de versão ou integridade dos dados. Ele mantém os dados centralizados e acessíveis a todos, permitindo a colaboração sem complicações.
DVC x Git
DVC foi criado para complementar o Git, introduzindo o conceito de versionamento de dados. Isso permite o controle de grandes arquivos que não devem ser armazenados diretamente em um repositório Git, mas que ainda precisam ser rastreados e versionados. Ele aproveita os recursos do Git para gerenciar diferentes versões de dados, pipelines de dados e experimentos.
Embora o DVC funcione bem com o Git, não é obrigatório usá-lo junto. O DVC pode operar de forma independente, exceto para funcionalidades relacionadas ao versionamento.
DVC Não Substitui o Git!
O DVC utiliza metaarquivos como dvc.yaml e arquivos .dvc, que atuam como referências para versionar dados e pipelines de machine learning. Esses arquivos acompanham as mudanças nos seus dados e podem ser colocados sob controle de versão no Git.
Assim, o Git atua como um proxy para os dados reais, que são armazenados em cache fora do Git.
Comandos Similares ao Git
O DVC oferece comandos que lembram os comandos do Git, como:
dvc init– Inicializa um repositório DVC.dvc add– Adiciona arquivos grandes ao controle do DVC.dvc checkout– Restaura arquivos versionados com o DVC.dvc push– Envia dados para um armazenamento remoto.
Esses comandos interagem com o repositório Git, se você estiver usando um, mas o Git não é necessário para usar o DVC. O DVC, portanto, expande as funcionalidades do Git, mas mantém seu foco principal no controle eficiente de dados e experimentos.
A integração do DVC com o Git torna o gerenciamento de dados e código mais eficiente e colaborativo!
Como Usar o DVC?
1. Instale o DVC
A primeira etapa é instalar o DVC. Isso pode ser feito facilmente com o seguinte comando:
pip install dvc2. Inicialize o Repositório
Depois de instalar, crie um repositório DVC no seu projeto com:
dvc initPara usar o DVC junto com o git, no mesmo diretório execute:
git init3. Versionamento de Dados
Para começar a versionar dados, basta usar o comando dvc add:
dvc add <seu_arquivo>4. Commitando as Mudanças
Após adicionar os dados com o DVC, você precisa adicionar os arquivos modificados ao Git e fazer um commit, assim como faria com o código:
git add .  # Adiciona os arquivos de dados e de controle do DVC
git commit -m "Adicionando dados ao projeto"

# Adiciona o arquivo DVC no git e atualiza .gitignore
git add <seu_arquivo>.dvc .gitignore
5. Armazenando Dados em um Repositório Remoto
Para compartilhar seus dados e modelos, você pode usar um armazenamento remoto, como S3, Google Drive, ou outros serviços. Configure um repositório remoto com o comando:
dvc remote add -d myremote <URL_do_armazenamento>
dvc push  # Envia os dados para o repositório remoto
6. Trabalhando com Dados de Forma Colaborativa
Quando outra pessoa do seu time precisar acessar os dados, ela pode simplesmente usar o comando dvc pull para baixar os dados do repositório remoto:
dvc pull # Baixa os dados para o repositório local7. Automatizando Pipelines com DVC
Além do versionamento de dados, o DVC também permite criar pipelines automatizados para seu fluxo de trabalho. Isso é útil para processar dados, treinar modelos e fazer ajustes automaticamente. Para definir um pipeline, você pode usar o comando dvc run:
dvc run -n treino_modelo -d dados -o modelo python treino.pyIsso cria um pipeline que executa o script treino.py, usando os dados como entrada e gerando um modelo como saída.
Conclusão
O DVC pode ser uma ferramenta poderosa para toda(o)s que trabalham com dados e IA, tornando a gestão de projetos mais eficiente, colaborativa e reprodutível.
Ao integrar o DVC ao seu fluxo de trabalho, você pode se concentrar no que realmente importa: inovar e criar soluções que transformem o mundo da tecnologia.
Se você ainda não começou a usar o DVC, este é o momento perfeito para explorar seu potencial e otimizar seu trabalho.
Vamos seguir aprendendo e crescendo na área de tecnologia!
Link blog: Como versionar arquivos grandes? – Mulheres Programando